《极海芯得》系列内容为用户使用极海系列产品的经验总结,均转载自21ic论坛极海半导体专区,全文未作任何修改,未经原文作者授权禁止转载。
先说点题外话
兄弟们,如果你刚开始学嵌入式C语言,肯定经常看到别人代码里写这两种东西:
#defineMAX_BUFFER 256
typedef unsigned char uint8_t;
一看,诶,这不都是在"起名字"嘛!那我用哪个不都一样?
还真不一样!
这俩玩意儿虽然表面上看都是"给东西起个别名",但它们干活的原理、适合的场景、出错后的后果,完全不是一个级别的。
第一章:先搞清楚一个事——你的代码是怎么变成能跑的程序的?
在讲 #define 和 typedef 的区别之前,你得先知道一件事:你写的C代码,不是直接就能让芯片执行的。中间要经过好几道工序。
当你在编程软件里点"编译"按钮的时候,其实发生了一连串的处理过程。咱们把它简化成几个关键步骤:
下面这张图展示了C代码从源代码到可执行文件的完整流程,以及#define和 typedef 分别在哪个阶段被处理:
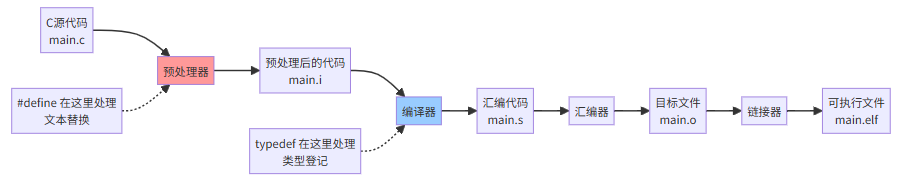
从图中可以看到,#define 在第一步就被预处理器处理掉了,而 typedef 要等到第二步才由编译器处理。这就是它们最根本的区别。
第一步:预处理(Preprocessing)
预处理器是你代码遇到的"第一道关卡"。它的任务特别简单:处理所有以 # 开头的指令。啥叫"以 # 开头的指令"呢?比如:
#include —— 把标准库头文件的内容"复制粘贴"到你的代码里
#define MAX 100 —— 做个标记,后面遇到 MAX 就替换成 100
#ifdef DEBUG —— 条件判断,决定某段代码要不要保留
预处理器就像个只会做文字替换的机器人。它不懂C语言的语法规则,不知道啥是变量、啥是类型、啥是函数。它只认识 # 开头的命令,然后机械地执行"找到→替换"这个动作。处理完之后,你的源代码会变成一份"展开后"的纯文本,交给下一步。
第二步:编译(Compilation)
编译器拿到预处理后的代码,才开始真正"理解"C语言。它会干这些事:
检查语法对不对
识别变量、函数、类型这些东西
做类型检查(比如你不能把字符串赋值给整数变量)
把C代码翻译成汇编代码
typedef 就是在这一步被处理的。 编译器会把它当作一个正式的类型声明来对待,给它分配符号表条目,进行完整的类型检查。
第三步:汇编和链接(Assembly & Linking)
汇编器把汇编代码变成机器码(目标文件),链接器把多个目标文件拼在一起,生成最终的可执行文件。这两步跟咱们今天的主题关系不大,先不展开。
关键结论
记住这个核心区别:
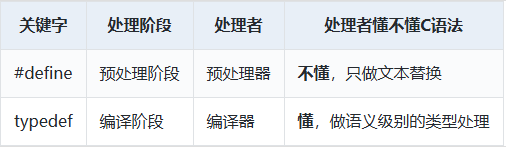
这个区别是一切差异的根源。后面所有的不同表现,都可以从这里推导出来。
第二章:深入聊聊 #define —— "文本替换"到底是个啥意思?
2.1 最基本的用法
#define 的语法特别简单:
#define名字 替换内容
比如:
#definePI 3.14159
#defineBOARD_NAME "APM32F407"
当预处理器扫描到你的代码时,它会把所有出现 PI 的地方,原封不动地替换成 3.14159;把所有出现 BOARD_NAME 的地方替换成 "APM32F407"。
注意关键词:原封不动。预处理器不做任何思考,不会加括号,不会考虑上下文。它就是个"查找并替换"的工具,跟你用文本编辑器的 Ctrl+H 没本质区别。
2.2 一个经典的"坑"
正因为预处理器不做任何智能处理,所以 #define 很容易在不经意间制造Bug。来看个例子:
#defineLENGTH 10 + 20
int array[LENGTH * 2];
你期望数组的大小是多少?直觉上可能是 (10 + 20) * 2 = 60。
但实际上,预处理器会把 LENGTH 替换成 10 + 20,所以数组声明变成了:
int array[10 + 20 * 2];
根据运算优先级,乘法先算,结果是 10 + 40 = 50,而不是你以为的 60。
这就是"文本替换"的代价。预处理器不理解数**算规则,它只是把字符串搬过来。
下面这张图直观展示了宏替换的过程,以及为什么会出现优先级问题:
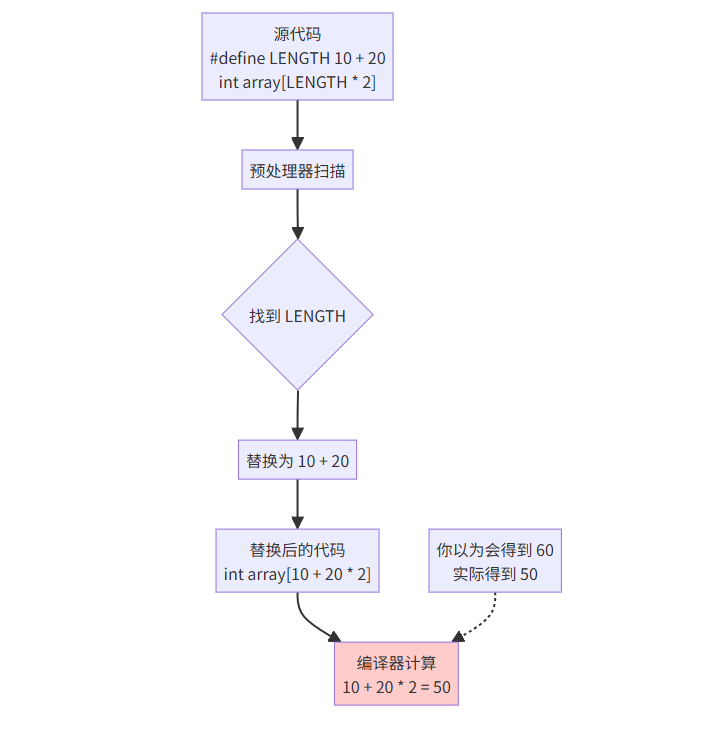
看到了吗?预处理器只是简单地把 LENGTH 替换成 10 + 20,完全不管运算优先级。所以 10 + 20 * 2 按照数学规则,先算乘法,结果是 50 而不是 60。
正确的写法是加括号:
#defineLENGTH (10 + 20)
这样替换后就变成了 (10 + 20) * 2 = 60,符合预期。
2.3 带参数的宏(函数式宏)
#define 还可以定义带参数的宏,看起来像个函数:
#defineDOUBLE(x) ((x) * 2)
使用时:
int result = DOUBLE(5); // 替换为 ((5) * 2),结果是 10
int result2 = DOUBLE(3 + 1); // 替换为 ((3 + 1) * 2),结果是 8
下面这张图展示了函数式宏的展开过程:
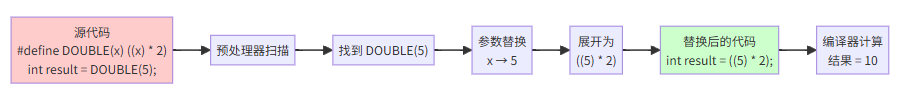
整个过程就是:预处理器找到宏调用,把参数替换进去,然后把整个宏调用替换成展开后的表达式。注意每个参数都用括号包住了,这样即使传入的是复杂表达式也不会出问题。
这种写法在嵌入式开发中特别常见,因为它没有函数调用的开销。普通函数调用需要压栈、跳转、出栈,而宏展开后就是直接嵌入代码,执行速度和手写表达式一样快。
在嵌入式系统中,很多操作对时间特别敏感(比如中断服务程序),所以这种"零开销"的特性很有价值。
2.4 宏的其他重要用途
除了定义常量和函数式宏,#define 还承担了几个关键角色:
条件编译:根据不同的配置,决定哪些代码参与编译。
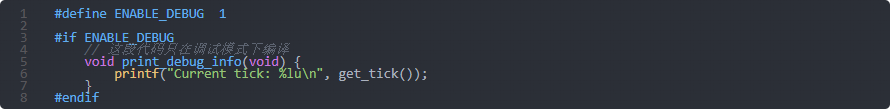
硬件抽象:把寄存器的物理地址映射成有意义的名字。
#defineTIMER1_BASE_ADDR 0x40010000
#defineTIMER1_CNT (*(volatile unsigned int *)(TIMER1_BASE_ADDR + 0x24))
功能开关:控制某个功能模块是否启用。
#defineUSE_LCD_DISPLAY 1
#defineUSE_UART_LOG 0
这些用途有个共同特点:它们都不涉及C语言的类型系统。预处理器只需要做文本层面的工作就够了。
2.5 #define 的局限性
说了这么多优点,#define 的缺点也很明显:
1.没有类型检查:#define VALUE 100 和 #define VALUE "100" 在预处理阶段看起来没区别,都是文本。只有到了编译器阶段,用错了地方才会报错,而且报错信息往往指向替换后的代码,让人一头雾水。
2. 没有作用域概念:一旦在某处 #define 了一个名字,它会一直生效到文件末尾(或者遇到 #undef)。它不遵守大括号 {} 划定的作用域规则。这意味着你在一个函数里定义的宏,可能会影响到完全不相关的另一个函数。
3. 调试困难:大多数调试器在符号表里看不到宏的名字。当你单步调试时,看到的是替换后的数字或表达式,而不是你定义的宏名。排查宏相关的Bug时,经常需要手动查看预处理后的中间文件(.i 文件)。
4. 容易命名冲突:因为宏是全局生效的,如果你的宏名和别人库里的宏名撞了,就会出问题。所以嵌入式项目里,宏名通常要加上项目前缀,比如 MYPROJ_MAX_RETRY。
第三章:深入聊聊 typedef —— "类型别名"到底是个啥意思?
3.1 最基本的用法
typedef 的语法也很简单:
typedef 已有类型 新名字;
比如:
typedef unsigned char byte_t;
typedef unsigned int word_t;
这之后,你就可以用 byte_t 代替 unsigned char,用 word_t 代替 unsigned int:
byte_t sensor_value; // 等价于 unsigned char sensor_value;
word_t timestamp; // 等价于 unsigned int timestamp;
但这里有个关键区别:typedef 不是文本替换。编译器会把 byte_t 当作一个正式的类型名记录在符号表里。它知道 byte_t 就是 unsigned char,并且会基于这个认知进行类型检查。
3.2 typedef 最常见的应用场景
场景一:让基本类型的位宽明确
在嵌入式开发中,我们经常需要精确控制变量占用的字节数。比如一个通信协议规定某个字段是1字节,你就必须用恰好8位的类型来表示。
但问题是,C语言标准并没有规定 int 到底是16位还是32位,long 是32位还是64位——这取决于编译器和目标平台。
怎么办?用 typedef 来屏蔽平台差异:
你的业务代码只需要写 uint32_t timeout;,不需要关心底层到底对应什么原始类型。换平台时,只需要修改 typedef 的定义,业务代码一行都不用动。
下面这张图展示了 typedef 如何实现跨平台类型映射:
看到了吗?你的业务代码写的是 uint32_t,但在不同平台上,typedef 会把它映射到不同的底层类型。这样你就不用关心平台差异了,换平台时只需要改 typedef 的定义,业务代码一行都不用动。
实际上,C99标准已经把这件事标准化了—— 头文件里就包含了这些定义。
场景二:简化结构体的使用
在C语言中,定义一个结构体变量需要写 struct 关键字:
用 typedef 可以省掉这个麻烦:
在嵌入式项目中,结构体用得特别多(寄存器映射、通信帧、状态机等),typedef 能让代码清爽很多。
场景三:给函数指针起名字
这可能是 typedef 最"不可替代"的用途了。函数指针的原始语法特别难读:
// 一个指向"接收int参数、返回void"的函数的指针
void (*callback)(int);
如果要在结构体里用、在函数参数里用,可读性会更差:
用 typedef 改造后:
清爽多了。而且当你声明变量时,类型名本身就带有语义信息,一看就知道这个函数指针是用来做什么的。
3.3 typedef 的核心优势
和 #define 相比,typedef 有几个本质性的优势:
优势一:遵守作用域规则
typedef 定义的类型名,遵循C语言的标准作用域规则。如果你在函数内部定义了一个 typedef,它只在这个函数内部有效:
而 #define 没有这个概念——一旦定义,整个文件(包括所有 #include 进来的头文件之后的部分)都能看到。
下面这张图直观展示了 #define 和 typedef 在作用域上的区别:
看到了吗?#define 定义的 MAX 在整个文件里都有效,不管你在哪个函数里。而 typedef 定义的 MyInt_t 只在定义它的那个函数里有效,出了那个函数就不认识了。这就是"作用域"的区别。
优势二:编译器会做类型检查
typedef 创建的类型名会被编译器记录,当类型不匹配时,编译器能给出有意义的错误提示:
注意:上面这个赋值在C语言中不会报错(因为底层都是 unsigned long),但如果你用 typedef 配合结构体包装,就可以实现更强的类型隔离:
这种方式在安全关键的嵌入式项目中特别有用。
优势三:对调试器友好
现代调试器(如GDB、J-Link Debugger)能识别 typedef 定义的类型名。当你在调试器里查看变量时,它会显示 Timestamp_t 而不是 unsigned long,帮助你更快地理解每个变量的用途。
而 #define 定义的名字在预处理阶段就消失了,调试器根本看不到。
优势四:指针场景下行为正确
这是个特别经典的对比:
为啥会这样?因为 #define 是纯文本替换,PINT a, b 展开后变成 int *a, b,星号只跟 a 绑定。而 typedef 把 int * 当作一个完整的类型来登记,所以 pInt_t 代表的就是"指向int的指针"这个完整类型,c 和 d 都是这个类型。
下面这张图展示了为什么 #define 在指针场景下会出问题:
关键区别在于:#define把 int * 拆成了文本碎片,星号只跟第一个变量绑定;而 typedef 把 int * 当作一个完整的类型,所有用这个类型声明的变量都是指针。
第四章:核心差异对比 —— 一张表看清本质
经过前面的详细分析,我们可以把两者的差异总结如下:
第五章:实战指南 —— 什么场景该用哪个?
理论讲完了,回到实际开发中。面对一个具体需求,怎么快速判断该用 #define 还是 typedef?
5.1 必须用 #define 的场景
场景A:定义常量值
#define SYSTEM_TICK_MS 10
#define MAX_RETRY_COUNT 3
#define BAUDRATE_115200 115200
这些是纯粹的数值,不需要类型信息,用 #define 最合适。
场景B:定义简单的运算宏
#defineABS(x) ((x) < 0 ? -(x) : (x))
#defineMIN(a, b) (((a) < (b)) ? (a) : (b))
#defineARRAY_SIZE(arr) (sizeof(arr) / sizeof((arr)[0]))
这些宏展开后是表达式,没有函数调用开销,适合频繁调用的简单运算。
场景C:条件编译和功能裁剪
这种"根据配置决定编译哪些代码"的能力,只有预处理指令能做到。typedef 完全无法参与这个过程。
场景D:硬件寄存器映射
#defineGPIO_PORTA_BASE 0x40020000UL
#defineGPIO_PORTA_MODE (*(volatile uint32_t *)(GPIO_PORTA_BASE + 0x00))
#defineGPIO_PORTA_OUTPUT (*(volatile uint32_t *)(GPIO_PORTA_BASE + 0x14))
硬件地址是固定的数值,需要在编译期被替换成常量,这是#define的本职工作。
5.2 必须用 typedef 的场景
场景A:定义跨平台的标准类型
#include
uint8_t spi_buffer[256]; // 精确8位,跨平台一致
uint16_t adc_raw_value; // 精确16位
int32_t temperature_offset; // 精确32位有符号
***不要用 #define 来模拟这种类型定义。 里的类型是用 typedef 实现的,经过编译器验证,安全可靠。
场景B:定义复杂的数据结构
结构体和枚举配合 typedef,让代码既简洁又有类型安全。
场景C:定义函数指针类型(回调函数)
typedef void (*TimerCallback_t)(uint32_t elapsed_ms);
typedef int (*DataParser_t)(const uint8_t *raw, uint16_t len, void *output);
// 使用
TimerCallback_t my_callback = on_timer_expired;
register_timer_callback(my_callback);
如果不用 typedef,函数指针的声明会特别难读,尤其是在嵌套使用时。
5.3 一个快速判断的方法
当你犹豫该用哪个时,问自己三个问题:
1.这个东西有"类型"的概念吗?如果答案是"是"(比如它描述的是某种数据结构、某种指针),用 typedef。如果答案是"否"(比如它只是一个数字、一段文本),用 #define。
2.它需要参与条件编译(#if/#ifdef)吗?如果需要,只能用 #define。
3.你希望调试器和IDE能识别这个名字吗?如果是,用 typedef。#define 的名字在预处理后就消失了。
下面这张决策流程图可以帮你快速判断该用 #define 还是 typedef:
简单总结一下判断逻辑:
如果要参与条件编译,只能用 #define
如果涉及类型(结构体、指针等),用 typedef
如果需要调试器友好,用 typedef
其他情况(纯数值常量、简单宏),用#define
第六章:新手常踩的几个坑
坑一:宏定义忘记加括号
#defineSQUARE(x) x * x
int result = SQUARE(1 + 2);
// 展开为:1 + 2 * 1 + 2 = 5,而不是预期的 9
正确写法:参数和整体表达式都要加括号。
#defineSQUARE(x) ((x) * (x))
这条规则要刻进DNA里。每次写函数式宏,都要条件反射般地加括号。
坑二:宏参数带有副作用
因为宏展开后,a 出现了两次,所以 x++ 会被求值两次。而如果是真正的函数调用,参数只求值一次。
下面这张图展示了宏的副作用问题:
这就是宏的"坑":同一个参数在宏体中出现多次时,如果传入的表达式有副作用(比如 x++),就会被执行多次。而普通函数调用不会有这个问题,因为参数只求值一次。
解决办法:对于这种场景,用 static inline 函数代替宏:
static inline int max_int(int a, int b) {
return (a > b) ? a : b;
}
static inline 函数既有函数调用的安全性(参数只求值一次),又能让编译器内联展开(和宏一样没有调用开销)。
坑三:用 #define 定义"类型"导致语法错误
#defineMyBuffer unsigned char[128]
MyBuffer data; // 语法错误!
预处理器展开后变成 unsigned char[128] data;,这不是合法的C语法。
而用 typedef:
typedef unsigned char MyBuffer_t[128];
MyBuffer_t data; // 完全合法,data 是一个128字节的数组
坑四:宏的命名冲突
解决办法:给宏名加上项目或模块前缀。
#defineMYAPP_MAX_COUNT 10
#defineMYAPP_MIN_COUNT 1
坑五:误以为 typedef 创建了新类型
typedef 只是给已有类型起了个别名,并没有创造新类型:
如果你需要真正的类型隔离(防止不同类型之间意外赋值),需要用结构体包装:
第七章:进阶话题 —— 在大型嵌入式项目中的最佳实践
7.1 类型命名的约定
在大型项目中,良好的命名约定能极大提高代码可读性。常见的做法是:
typedef 定义的类型名以 _t 结尾(POSIX标准约定)
结构体类型名用 PascalCase(大驼峰)
枚举类型名用 PascalCase,枚举值用 UPPER_SNAKE_CASE
7.2 宏定义的安全写法
对于函数式宏,遵循以下原则可以规避大部分问题:
1. 所有参数用括号包裹
2. 整个表达式用括号包裹
3. 避免参数出现副作用
4. 如果逻辑复杂,改用 static inline 函数
7.3 条件编译的组织方式
在大型项目中,通常会有一个专门的配置头文件来集中管理所有编译选项:
然后在代码中根据这些配置来裁剪功能:
下面这张图展示了条件编译的工作流程:
看到了吗?通过条件编译,你可以根据配置决定哪些代码参与编译。在发布版本中,调试代码会被完全剔除,不占用任何ROM空间。这种"按需裁剪"的能力在资源紧张的嵌入式系统中特别重要。
这种模式在嵌入式SDK和RTOS中特别普遍。
第八章:总结
让我们回到最初的问题:#define 和 typedef 到底有什么区别?
用一句话概括:
#define是预处理器的文本替换工具,它在编译器看到代码之前就完成了工作;typedef 是编译器的类型别名工具,它参与完整的类型检查和作用域管理。
它们不是竞争关系,而是互补关系。在嵌入式C开发中,两者各有不可替代的用途:
#define 负责:常量定义、宏函数、条件编译、硬件地址映射——这些"不需要类型信息"的工作。
typedef 负责:类型别名、结构体简化、函数指针封装、跨平台类型抽象——这些"需要类型系统参与"的工作。
作为新手,你不需要一次性记住所有细节。只需要记住那个核心判断标准:这个东西需要编译器理解它的"类型"吗? 如果需要,用 typedef;如果不需要,用 #define。
随着你写的项目越来越多,这些概念会自然融入你的编码习惯中。到那时,你会发现自己不再纠结"该用哪个",而是自然而然地做出正确的选择——因为你已经理解了它们背后的原理。
补充:const、#define、typedef 三者对比
很多新手还会把 const 也拉进来比较。这里简单理清三者的关系:
简单区分:
#define 定义的是值(没有类型的值)
const 定义的是只读变量(有类型,但不能修改)
typedef 定义的是类型名(不是值,也不是变量)
举个例子:
#defineMAX_SIZE 100 // 预处理时把所有 MAX_SIZE 替换成 100
const int buffer_size = 256; // 一个只读的 int 变量,有地址
typedef int BufferIndex_t; // int 类型的别名,不是值也不是变量
常见疑问
Q1:#define和 typedef 都能起别名,有什么区别?
A:#define 是预处理阶段的文本替换,不做类型检查;typedef 是编译阶段的类型别名登记,参与完整的类型检查。最典型的例子是指针场景:#define PINT int * 在声明多个变量时会出错,而 typedef int *pInt_t 不会。
Q2:为什么嵌入式项目中类型定义推荐用 typedef 而不是#define?
A:因为 typedef 会被编译器记录在符号表中,调试器能看到、IDE能跳转、编译器能做类型检查。而 #define 在预处理后就消失了,出了问题排查困难。
Q3:#define定义的宏能参与#if条件判断吗?typedef 呢?
A:#define 能,因为它本质上是一个值(文本),预处理器可以在编译前判断它。typedef 不能,因为它是一个类型名,不是值,预处理器无法对它做数值比较。
Q4:什么时候用 static inline 函数代替宏?
A:当宏的逻辑比较复杂、参数可能有副作用(如 i++)、或者需要类型安全时,用 static inline 函数更好。它既有函数调用的安全性,又能让编译器内联展开,没有额外的调用开销。
附录:速查表
写在最后:学编程就是学"工具背后的原理"
兄弟们,写到这儿,咱们这篇文章也快收尾了。
回头看看,其实 #define 和 typedef 的区别,说白了就一句话:一个在编译器干活之前就偷偷把代码改了,另一个是编译器自己正儿八经处理的。
你可能会觉得,这不就是两个关键字嘛,有啥大不了的?
但我想说的是,理解工具背后的原理,比单纯记住用法重要一万倍。
你想想,如果你只知道"#define 是定义常量,typedef 是定义类型别名",那你遇到实际问题的时候,还是不知道怎么选。但如果你理解了它们分别在编译流程的哪个阶段工作,理解了预处理器和编译器各自干啥,那你自然就知道什么场景该用谁了。
这种"理解原理再使用"的思路,适用于编程里的方方面面。比如:
volatile 和 const:一个告诉编译器"别优化这个变量",一个告诉编译器"这个变量不能改"
static 和 extern:一个控制变量的"可见范围",一个声明"这个变量在别的地方"
inline 和函数指针:一个让函数"内联展开",一个让函数"可以当参数传递"
这些关键字本身不难,难的是你是否清楚它们各自工作在编译器流水线的哪个位置上。
希望这篇文章能帮你彻底搞懂 #define 和 typedef 的区别。如果有任何疑问,欢迎在评论区讨论。
原文地址:https://bbs.21ic.com/icview-3522935-1-4.html?_dsign=2cf5d26e